Kısaca
Yapay Zekâ Entegrasyonu nedir?
Yapay zekâ entegrasyonu; büyük dil modellerinin (LLM) bir işletmenin kendi dokümanları, yazılımları ve iş süreçleriyle güvenli şekilde bağlanmasıdır. Şirket bilgisinden cevap veren asistanlar, belirli görevleri adım adım yürüten yapay zekâ ajanları ve içerik ya da müşteri desteği otomasyonları bu hizmetin başlıca uygulamalarıdır.
Yapay Zekâ Entegrasyonu hizmetimizin kapsamı
-
01
Doküman tabanlı asistan (RAG)
Prosedür, ürün kataloğu, sözleşme ve destek dokümanlarınızın aranabilir hale getirilmesi; cevapların ilgili kaynağa atıfla üretilmesi.
-
02
Yapay zekâ ajanları
Talep sınıflandırma, bilgi toplama, taslak hazırlama ve yazılımlarda kayıt oluşturma gibi çok adımlı işlerin tanımlı araçlarla yürütülmesi.
-
03
Müşteri destek otomasyonu
Web sitesi, WhatsApp veya e-posta üzerinden gelen soruların ön cevaplanması ve gerektiğinde temsilciye aktarılması.
-
04
İçerik ve doküman otomasyonu
Ürün açıklaması, teklif taslağı, toplantı özeti ve rapor gibi metinlerin marka ve şablon kurallarına göre hazırlanması.
-
05
Sistem entegrasyonları
Yapay zekânın CRM, e-ticaret, destek ve doküman yönetimi yazılımlarıyla API üzerinden bağlanması.
-
06
İnsan onayı (human-in-the-loop)
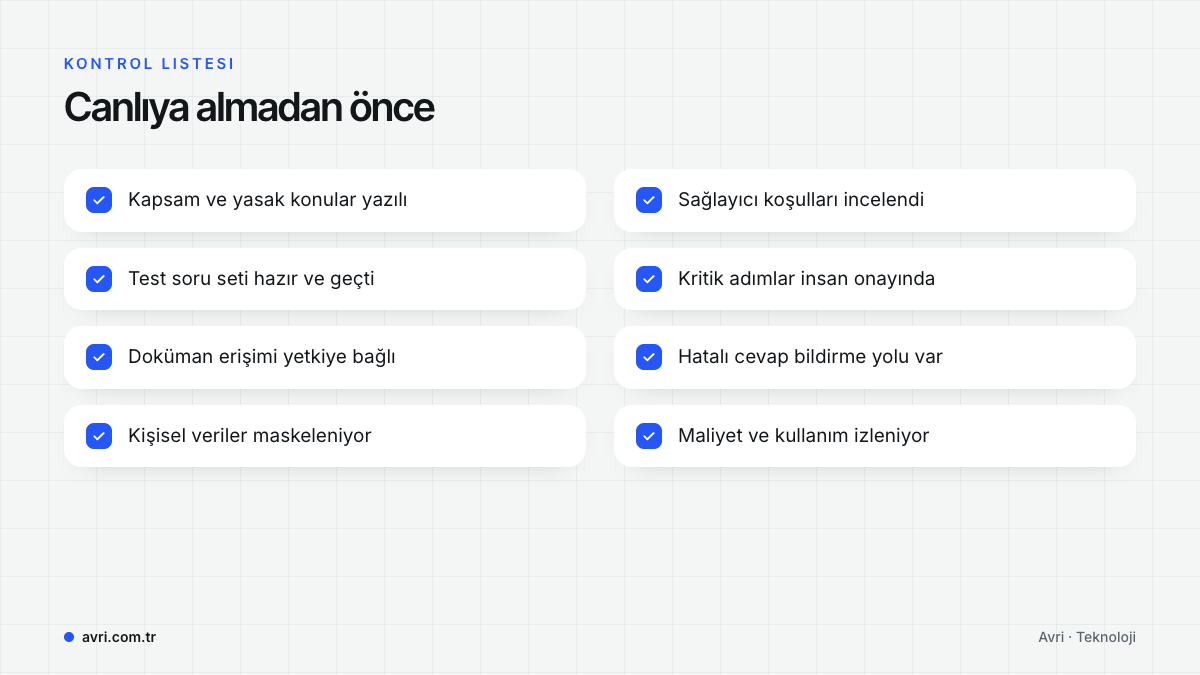
Müşteriye giden mesaj, fiyat, iade veya kayıt değişikliği gibi kritik adımların gönderilmeden önce yetkili onayına sunulması.
-
07
Veri güvenliği ve KVKK
Kişisel verilerin maskelenmesi, yetki bazlı doküman erişimi, model sağlayıcısının veri kullanım koşullarının ve yurt dışı aktarımın değerlendirilmesi.
-
08
Kalite ölçümü
Örnek soru setleriyle cevap doğruluğunun test edilmesi, hatalı cevapların kayıt altına alınması ve düzenli iyileştirme.
Kimler için uygun?
- Ekibi aynı soruları tekrar tekrar cevaplayan destek ve satış birimleri
- Bilgisi çok sayıda doküman, klasör ve e-postaya dağılmış şirketler
- Tekrarlayan metin, sınıflandırma ve veri girişi işlerini hızlandırmak isteyen ekipler
- Çalışanların yapay zekâyı kontrolsüz kullanmasından endişe eden ve kurumsal bir çerçeve arayan yöneticiler
Nasıl çalışıyoruz?
-
1
Kullanım senaryosu seçimi
Zaman kaybı yüksek, riski yönetilebilir ve sonucu ölçülebilir senaryoların belirlenmesi.
-
2
Veri ve risk değerlendirmesi
Kullanılacak dokümanların, kişisel veri içeriğinin, erişim yetkilerinin ve model sağlayıcı seçeneklerinin incelenmesi.
-
3
Pilot
Sınırlı bir kullanıcı grubu ve veri setiyle çalışan ilk sürüm; örnek sorularla doğruluk ölçümü.
-
4
Entegrasyon ve yaygınlaştırma
Mevcut yazılımlara bağlama, onay adımlarının eklenmesi ve kullanıcı eğitimi.
-
5
İzleme ve iyileştirme
Cevap kalitesi, maliyet ve kullanım verilerinin takibi; doküman ve talimatların güncellenmesi.
Neler teslim ediyoruz?
- Kullanım senaryosu ve risk değerlendirme raporu
- Çalışan yapay zekâ asistanı veya ajan akışı
- Doküman indeksleme ve güncelleme altyapısı
- Yetkilendirme, onay ve kayıt mekanizmaları
- Test soru seti ve kalite raporu
- Kullanım kılavuzu ve yapay zekâ kullanım ilkeleri önerisi
Yapay zekâyı “denemekten” iş aracına dönüştürmek
Pek çok şirkette yapay zekâ kullanımı zaten başladı; sadece kimse tam olarak nerede ve nasıl kullanıldığını bilmiyor. Bir çalışan müşteri e-postasını genel bir sohbet aracına yapıştırıp cevap taslağı alıyor, bir başkası sözleşme maddesini özetletiyor. Bu kullanım hem dağınık hem de risklidir: Araç şirketin ürünlerini, fiyat politikasını ya da prosedürlerini bilmez; yapıştırılan metinlerde kişisel ya da ticari sır niteliğinde veriler bulunabilir.
Kurgusal bir örnek: 40 çalışanlı bir ısıtma sistemleri servis şirketi. Çağrı merkezine gelen soruların önemli bölümü hata kodları, garanti koşulları ve bakım periyotları gibi konular. Cevaplar yüzlerce sayfalık kılavuzlarda ve iç prosedürlerde var, ama yeni başlayan bir temsilcinin onları bulması dakikalar alıyor. Doğru kurulmuş bir yapay zekâ entegrasyonu, temsilciye ilgili kılavuz bölümünü gösteren ve cevabın kaynağını belirten bir yardımcı sunar; kararı yine temsilci verir.
Fark, modelin kendisinde değil, etrafına kurulan yapıdadır: hangi bilgiye erişeceği, neyi yapmasına izin verildiği, ne zaman susacağı ve kimin onayından geçeceği.
Ne zaman ihtiyaç duyarsınız?
- Ekip, cevabı dokümanlarda olan aynı soruları her gün tekrar tekrar cevaplıyor.
- Yeni çalışanların ürün ve prosedürleri öğrenmesi uzun sürüyor.
- Gelen talepleri okuyup sınıflandırmak ve doğru kişiye yönlendirmek ciddi zaman alıyor.
- Teklif, rapor ya da ürün açıklaması gibi metinler hep aynı kalıpla, elle yazılıyor.
- Çalışanların genel yapay zekâ araçlarına şirket verisi yapıştırdığını biliyor ama bir çerçeve sunamıyorsunuz.
- Bilgi; e-postalara, paylaşılan klasörlere ve kişilerin hafızasına dağılmış durumda.
Bu belirtilerin hiçbiri tek başına “yapay zekâ şart” demek değildir. Bazen sorun bilginin kendisindedir: Güncel bir sık sorulan sorular dokümanı, düzenli bir klasör yapısı ya da iyi tasarlanmış bir form, yapay zekâdan önce çözülmesi gereken adımlardır. Analiz aşamasında bunu da açıkça belirtir, yapay zekânın gerçekten fark yaratacağı noktaları ayırırız. Böylece bütçe, sonucu ölçülebilen işlere gider; teknoloji merakıyla başlatılıp yarım kalan pilotlara değil.
Nasıl yapıyoruz? Önce ölçüt, sonra model
Yapay zekâ projelerinde en sık görülen hata, önce bir araç seçip sonra ona iş aramaktır. Biz tersinden başlıyoruz: Hangi işin ne kadar iyi yapılması gerektiğini tanımlıyor, sonra bunu sağlayan en sade yapıyı kuruyoruz.
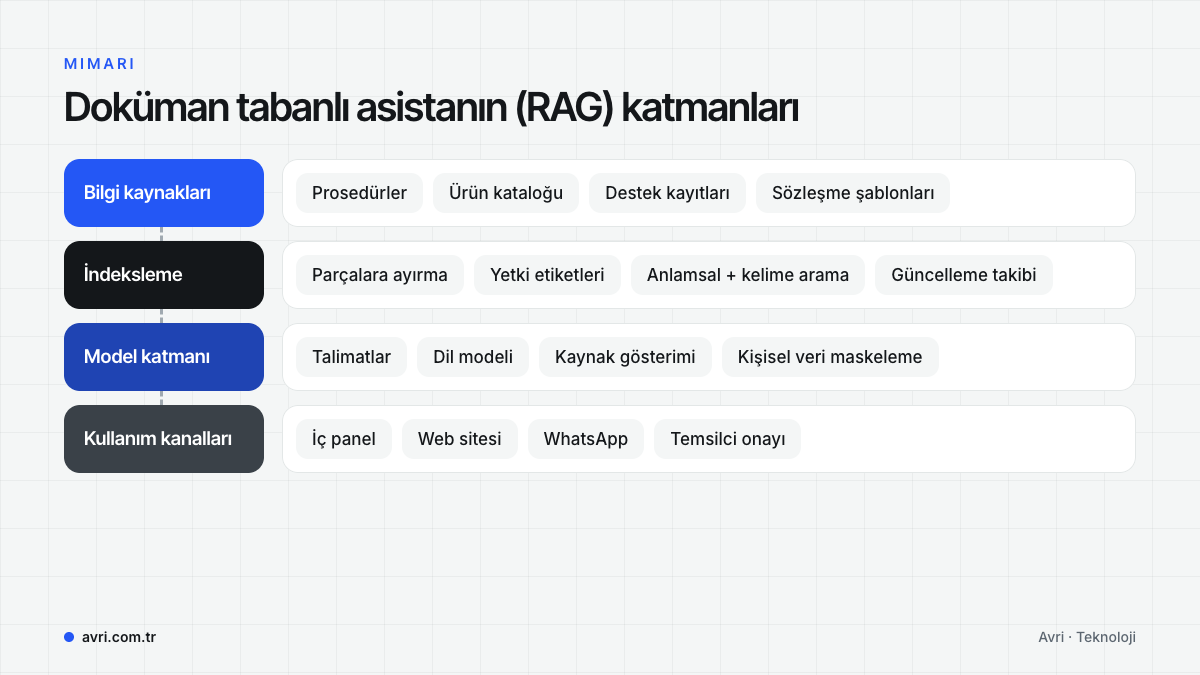
- Değerlendirme setini en başta yazmakSeçilen senaryo için gerçek hayattan alınmış, beklenen cevabı bilinen onlarca soru hazırlarız. Kolay sorular, belgelerde cevabı olmayan sorular ve yanıltıcı sorular bir arada bulunur. Her değişiklikten sonra sistem bu setle yeniden sınanır.
- Bilgi kaynaklarını hazırlamakGüncel olmayan, birbiriyle çelişen ya da taranmış görüntü olarak duran dokümanlar asistanın kalitesini doğrudan düşürür. Hangi belgenin “tek doğru kaynak” olduğuna sizinle birlikte karar veririz.
- Arama katmanını kurmakDokümanları anlamlı parçalara ayırır, her parçaya kim tarafından görülebileceğini belirten yetki etiketleri ekleriz. Anlamsal arama ile kelime aramasını birlikte kullanmak, ürün kodu ve hata kodu gibi tam eşleşme gerektiren sorgularda belirgin fark yaratır.
- Talimat ve sınırlarAsistanın yalnızca bulunan kaynaklara dayanmasını, kaynağı göstermesini, bilmediğinde bunu söylemesini ve kapsam dışı konularda yönlendirme yapmasını talimatlarla tanımlarız.
- Araçlar ve onay adımlarıAjan bir kayıt oluşturacak ya da mesaj gönderecekse bunu tanımlı, dar yetkili araçlarla yapar. Müşteriye giden, para ya da kayıt değiştiren her işlem bir insanın onayına düşer.
- İzlemeCevap kalitesini, kullanıcıların “yanlış” işaretlediği cevapları, maliyeti ve gecikmeyi panelden izleriz. Dokümanlar güncellendiğinde indeks de güncellenir.
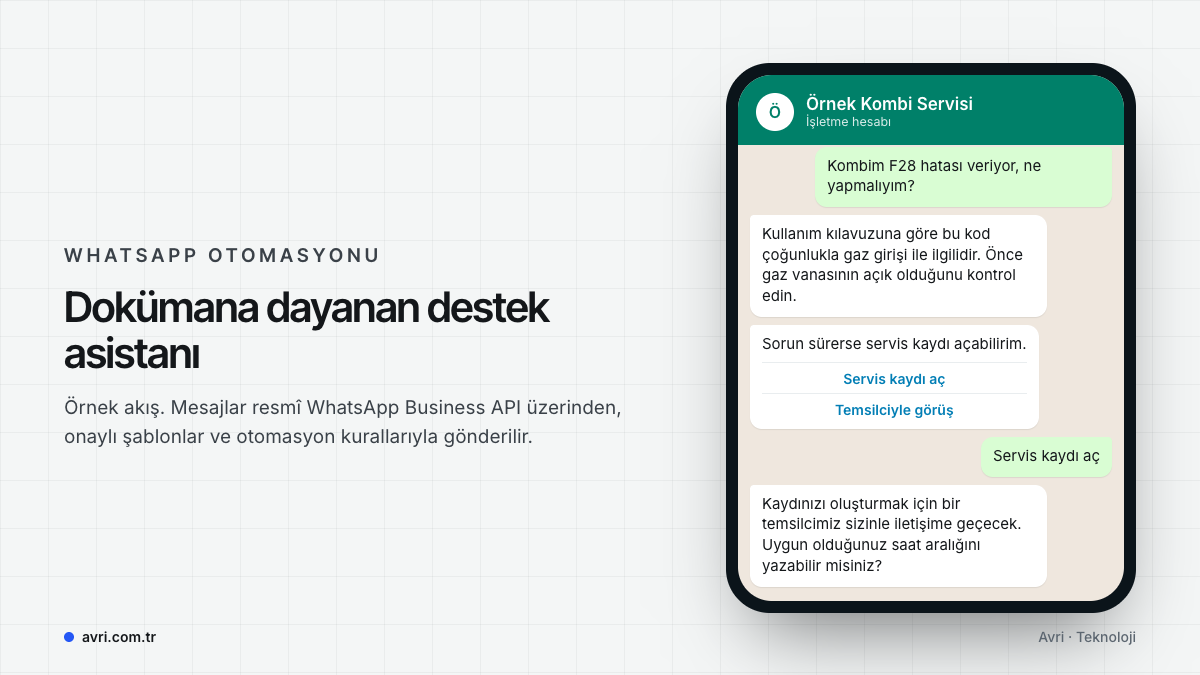
Asistan WhatsApp üzerinden çalışacaksa ayrıca Meta’nın platform kurallarını hesaba katmak gerekir. Meta, işletmenin kendi hizmetiyle ilgisi olmayan genel amaçlı yapay zekâ sohbet botlarını kısıtlayan politika değişiklikleri yaptı; ürün ve hizmetinize dair destek veren asistanlar ise bu kısıtın hedefi değildir. Kanal tarafını WhatsApp Business API otomasyonları hizmetimizle birlikte kurgularız.
Hangi senaryodan başlamalı?
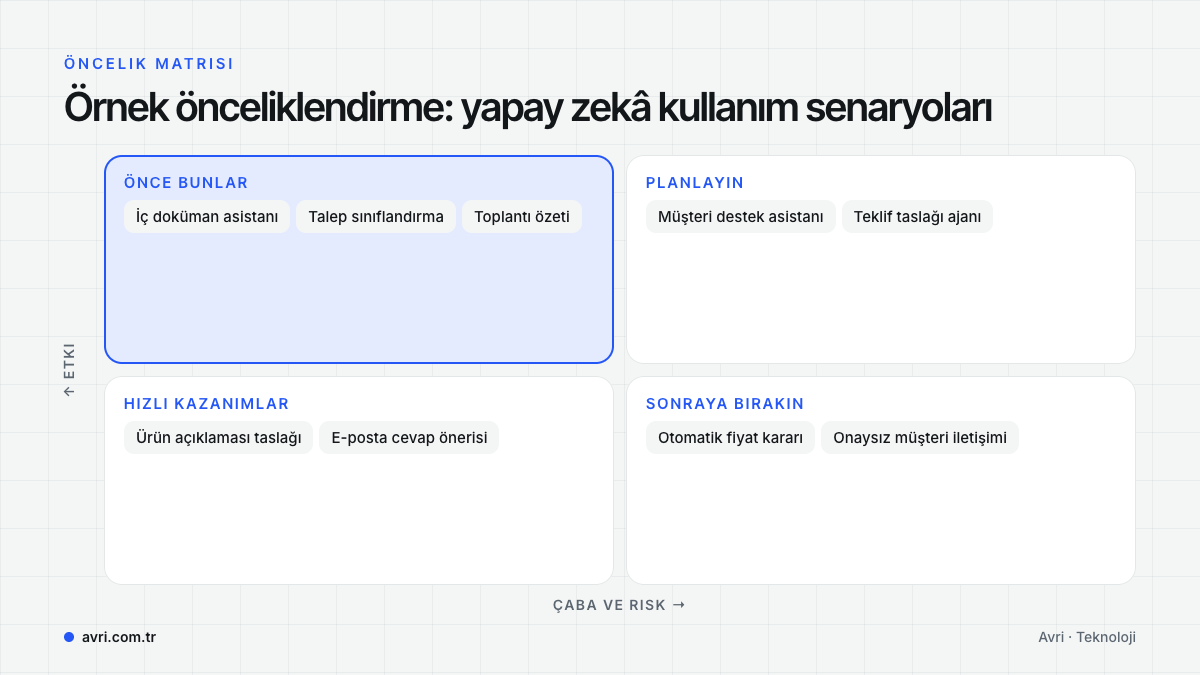
İyi bir ilk senaryo üç özelliği birlikte taşır: sık tekrarlanır, hatanın bedeli yönetilebilirdir ve sonucu ölçülebilir. Otomatik fiyat belirleme ya da onaysız müşteri iletişimi gibi yüksek riskli işler, olgun bir yapı kurulana kadar beklemelidir.
Seçenekler: sohbet aracı, RAG, ajan ya da ince ayar
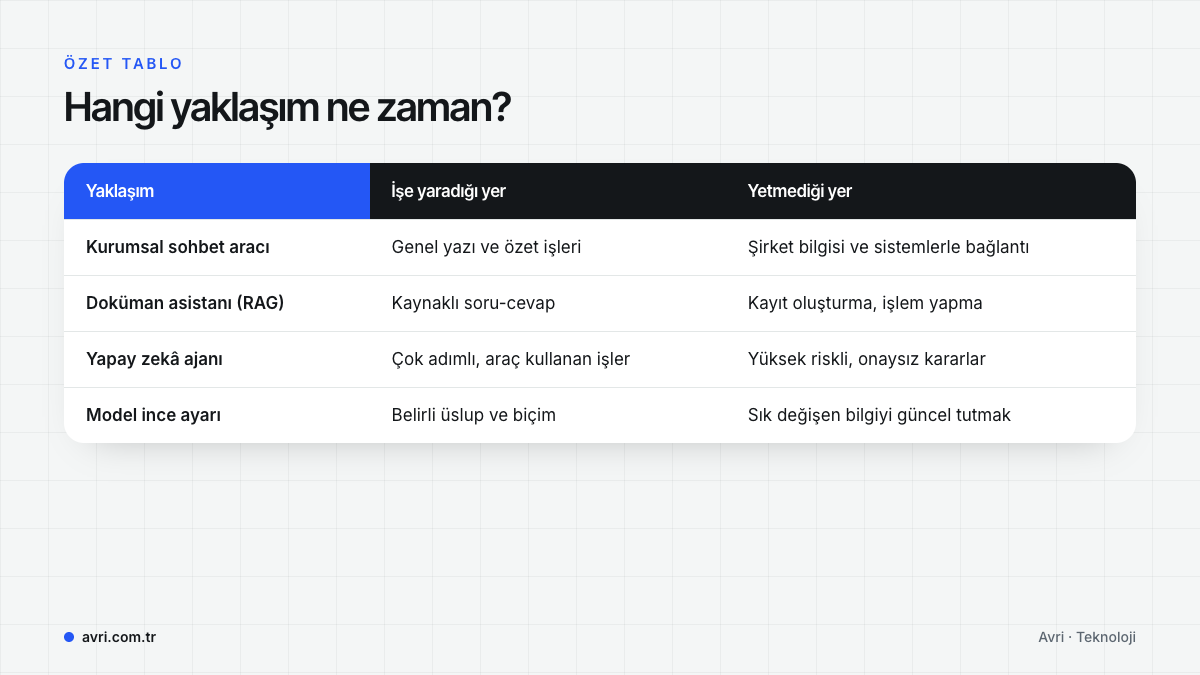
“Yapay zekâ entegrasyonu” tek bir şey değildir. Bazen kurumsal bir sohbet aracı ve iyi yazılmış kullanım ilkeleri yeterlidir; bazen dokümanlara dayanan bir asistan, bazen de sistemlerinizde işlem yapan bir ajan gerekir. Bir modeli kendi verinizle ince ayarlamak (fine-tuning) ise sanıldığından daha az durumda doğru cevaptır; sık değişen bilgiyi güncel tutmanın yolu çoğunlukla RAG’dir.
Ajanların hangi işlerde gerçekten zaman kazandırdığını ve nerede kesinlikle kullanılmaması gerektiğini yapay zekâ ajanları ile iş otomasyonu yazımızda; yapay zekâ gerektirmeyen otomasyonların n8n, Make ya da özel yazılımla nasıl çözülebileceğini ise iş süreci otomasyonu karşılaştırmamızda ele aldık. Her “akıllı” görünen iş yapay zekâ gerektirmez; kurala bağlanabilen işlerde klasik otomasyon hem daha ucuz hem daha öngörülebilirdir.
Güvenlik: yapay zekâya özgü riskler
Klasik yazılım güvenliğinin tüm kuralları burada da geçerlidir, ama dil modelleri birkaç yeni risk ekler. Bunların başında komut enjeksiyonu gelir: Asistanın okuduğu bir e-posta, web sayfası ya da doküman, içine gizlenmiş “önceki talimatları unut ve şunu yap” türünden ifadeler barındırabilir. Bu yüzden dış kaynaklardan gelen içeriği talimat olarak değil, yalnızca veri olarak ele alan bir yapı kurarız.
İkinci risk, gereğinden geniş yetkidir. Bir ajanın yalnızca okuması gereken bir sisteme yazma yetkisiyle bağlanması, hatalı bir cevabın gerçek bir kayda dönüşmesi demektir. Her araç için en dar yetkiyi tanımlar, yüksek etkili işlemleri onaya bağlar ve ajanın yaptığı her adımı kayıt altına alırız. Üçüncü risk ise yetki sızıntısıdır: Satış ekibinin görmemesi gereken bir insan kaynakları belgesi indekse girmişse, doğru soruyu soran herkes içeriğe ulaşabilir. Doküman bazlı yetki filtresi bu nedenle opsiyon değil, zorunluluktur.
Son olarak, model sağlayıcıları sürümlerini düzenli olarak yeniler ve eski sürümleri kullanımdan kaldırır. Model değiştiğinde aynı talimatlar farklı sonuç verebilir; değerlendirme setinin asıl değeri bu geçişlerde ortaya çıkar. Yeni bir sürüme geçmeden önce set yeniden çalıştırılır, fark varsa talimatlar düzeltilir.
Maliyeti ve süreyi ne belirler?
| Etken | Neden önemli |
|---|---|
| Kullanım hacmi | Model sağlayıcıları genellikle işlenen metin miktarına (token) göre ücretlendirir; soru sayısı ve cevap uzunluğu işletme maliyetini belirler. |
| Doküman miktarı ve durumu | Taranmış, dağınık ya da çelişkili dokümanlar hazırlık emeğini artırır. |
| Entegrasyon sayısı | CRM, destek ya da ERP gibi her bağlantı ayrı yetki, eşleme ve test demektir. |
| Risk düzeyi | Müşteriye açık ve işlem yapan sistemler daha kapsamlı test, onay ve kayıt mekanizması ister. |
| Barındırma ve model tercihi | Bulut API, bölgesel sunucu seçenekleri ya da kendi sunucunuzda açık kaynak model farklı maliyet ve bakım profilleri getirir. |
Kabaca bir aralık için proje maliyet hesaplayıcısını, hazır kapsamlar için paketler sayfamızı kullanabilirsiniz. Kullanım bazlı model ücretleri sağlayıcılar tarafından değiştirildiği için teklifte bunları ayrı bir kalem olarak, sizin tahmini kullanımınız üzerinden gösteririz.
Başarıyı nasıl ölçeriz?
- Doğruluk: Değerlendirme setindeki soruların ne kadarının doğru ve kaynağa dayalı cevaplandığı; her sürümde yeniden ölçülür.
- Doğru “bilmiyorum”: Cevabı belgelerde olmayan sorularda asistanın uydurmak yerine bunu belirtmesi.
- Kullanıcı geri bildirimi: Faydalı ve hatalı işaretlenen cevapların oranı ve konuları.
- Zaman: Seçilen işin pilot öncesi ve sonrası ne kadar sürdüğü; örneğin bir talebin sınıflandırılıp doğru kişiye ulaşma süresi.
- Maliyet ve gecikme: Cevap başına yaklaşık maliyet ve kullanıcının cevabı bekleme süresi.
Ölçümün amacı “yapay zekâ çalışıyor mu” sorusuna değil, “bu iş daha iyi yapılıyor mu” sorusuna cevap vermektir.
Pilot dönemin sonunda bu ölçütleri bir karar toplantısında birlikte değerlendiririz. Üç olası sonuç vardır: senaryo hedefini tutturmuştur ve daha geniş bir kullanıcı grubuna açılır; hedefe yaklaşmıştır ve belirli zayıf noktalar (eksik doküman, yanlış parçalama, belirsiz talimat) düzeltilerek pilot uzatılır; ya da beklenen faydayı sağlamamıştır ve durdurulur. Üçüncü sonuç da değerlidir, çünkü küçük bir pilotla öğrenilen ders, büyük bir yatırımdan sonra öğrenilenden çok daha ucuzdur. Yaygınlaştırma kararı verildiğinde kullanıcı eğitimleri, kullanım ilkeleri ve hatalı cevapların kime bildirileceği netleştirilir.
Sık yapılan hatalar
Yapın
- Pilotu tek ve net tanımlı bir senaryoyla başlatın.
- Değerlendirme setini model seçiminden önce hazırlayın.
- Cevaplarda kaynak gösterimini zorunlu tutun.
- Çalışanlar için yazılı yapay zekâ kullanım ilkeleri yayınlayın.
Yapmayın
- Tüm şirket klasörlerini yetki ayrımı yapmadan indekslemeyin.
- Müşteriye giden ilk sürümü insan onayı olmadan açmayın.
- Demo sırasında iyi görünen cevapları kalite ölçümü yerine koymayın.
- Kişisel verileri gerekmedikçe modele göndermeyin.
Yapay zekâ tek başına değil, bağlandığı sistemlerle değer üretir. Asistanın cevaplarını müşteri geçmişiyle zenginleştirmek için özel CRM, bayi ve sipariş sorularına cevap vermek için B2B bayi portalı entegrasyonlarını birlikte planlayabiliriz.
Yapay Zekâ Entegrasyonu hakkında sık sorulan sorular
RAG nedir, neden önemlidir?
RAG (Retrieval-Augmented Generation), yapay zekânın cevap üretmeden önce sizin dokümanlarınız içinden ilgili bölümleri bulup bunlara dayanarak cevap vermesidir. Modelin genel bilgisiyle tahmin yürütmesi yerine şirketinize ait güncel bilgiyi kullanmasını ve kaynağını göstermesini sağlar.
Yapay zekâ yanlış bilgi verebilir mi?
Evet, hiçbir yapay zekâ sistemi hatasız değildir. Bu riski kaynak gösterme, cevabı yalnızca belgelerdeki bilgiyle sınırlama, bilmediğinde “bilmiyorum” deme talimatları, test soru setleri ve kritik adımlarda insan onayıyla azaltırız.
Şirket verilerimiz yapay zekâ modelini eğitmek için kullanılır mı?
Bu, seçilen model sağlayıcısının ve hizmet planının koşullarına bağlıdır. Kurumsal API planlarında veriler genellikle model eğitiminde kullanılmaz; yine de sözleşme koşullarını, veri saklama sürelerini ve sunucu konumunu proje başında birlikte inceleriz.
KVKK açısından nelere dikkat etmek gerekir?
Kişisel verilerin gerekmedikçe modele gönderilmemesi, maskelenmesi, yetkisiz kişilerin erişememesi ve yurt dışında işlenen veriler için KVKK’daki aktarım şartlarının sağlanması gerekir. Teknik önlemleri biz kurarız; hukuki değerlendirmenin veri sorumlusu olarak sizin ve hukuk danışmanınızın onayından geçmesini öneririz.
Yapay zekâ çalışanların yerini mi alacak?
Bu hizmetin amacı tekrarlayan işleri azaltmak ve ekibinizin zamanını karar gerektiren işlere ayırmaktır. Kurduğumuz yapılarda müşteriye giden ve sonuç doğuran kararlar insan kontrolünde kalır.